 Mark van de Wiel
Afgelopen week eerde de Nederlandse biostatistiekgemeenschap postuum één van haar giganten, Hans van Houwelingen, met een symposium in Leiden. Er werden vele mooie woorden gesproken over zijn invloed op de medische statistiek als vakgebied. Eén van de sprekers, Ulrich Mansmann, lauwerde Hans als een onderzoeker die zijn werk besteedde aan het ontwikkelen van methoden die patiënten inzicht geven in de vaak onzekere toekomst die voor ze ligt. Eén quote van Ulrich bleef me in het bijzonder bij:
“Good (statistical) prediction is not an end in itself. Its significance lies in providing knowledge that helps people make decisions about lives that matter to them.”
In deze quote ligt voor mij veel opgesloten over wat statistiek ook in dit AI tijdperk nog relevant maakt. AI modellen vervangen steeds vaker statistische modellen voor het maken van medische voorspellingen. Maar de standaard AI-methodieken zijn zeer deterministisch; ze geven ons één voorspelling, maar zeggen niets over de vele mogelijke toekomsten (“lives”). Kortom: ze schieten te kort als het gaat om onzekerheidskwantificatie. Waarom is dit nu zo belangrijk?
1. Een voorspelling is waardeloos zonder onzekerheidskwantificatie
Ik geef u twee scenario’s voor de voorspelling van LDL-cholesterolwaardes over twee jaar. In beide gevallen is de voorspelde waarde 1.7, hetgeen in principe als een veilige waarde (< 2) wordt gezien. Stel nu dat we de onzekerheid van de beide voorspellingen wel weten. Deze geven we weer met een interval welke de ware waarde met een grote kans (bijv. 95%) bevat. In het eerste scenario is dat interval [1.5, 1.9]. In het tweede is het [1.3, 3.7]. Zou u nu nog steeds dezelfde conclusies trekken voor beide scenario’s?
2. Explainable AI is waardeloos zonder onzekerheidskwantificatie
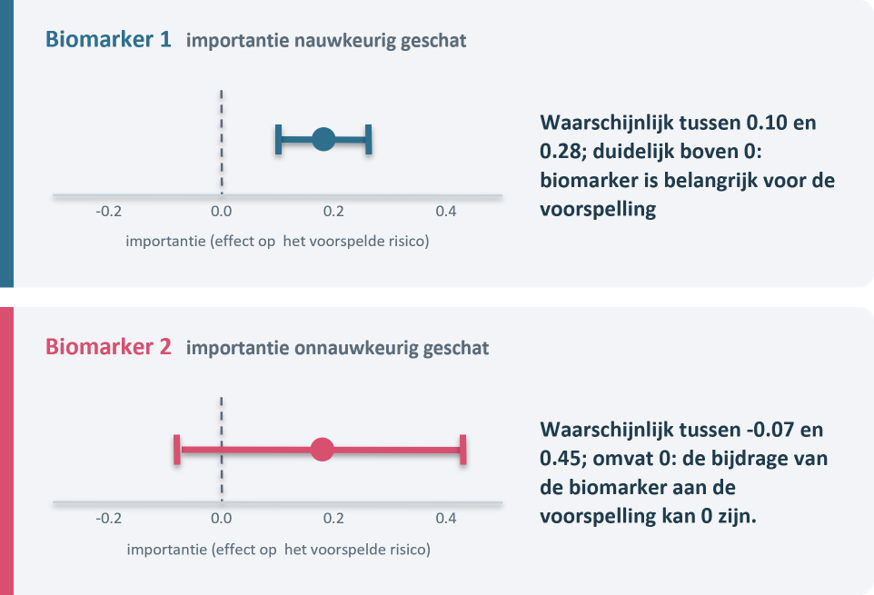
Explainable AI (xAI) wordt gezien als hét vakgebied om de AI black box doorzichtig te maken. Anthropic topman Amodei refereerde naar het belang hiervan in zijn brandbrief over de gevaren van AI. Met xAI worden AI voorspellingen achteraf geanalyseerd. Er wordt bepaald welke factoren en combinaties hiervan een voorspelling het meest beïnvloeden en voor wie. De populairste importantiemaat is SHAP, omdat deze allerlei prettige eigenschappen heeft, zoals decompositie: ze tellen op tot de voorspelling. Het figuur hieronder geeft deze importantie weer voor twee hypothetische biomarkers (bijv. genen). Ze hebben dezelfde geschatte importantie (≈ 0.19), maar alleen met de onzekerheidsweergave kunnen we tot de juiste conclusie komen: biomarker 1 is voor dit individu echt belangrijk voor de voorspelling, voor biomarker 2 is dit nog onzeker.
3. Predictieve prestatiematen zijn waardeloos zonder onzekerheidskwantificatie
Verschillende modellen worden vaak vergeleken op basis van hun voorspellende prestaties op nieuwe test data. In de medische setting hebben we vaak niet de luxe van hele grote test data sets; soms zijn ze niet groter dan n = 50. Veel prestatiematen worden gerapporteerd op een 0-1 schaal, waarbij 0.5 niet beter is dan willekeur en 1 perfect is. Bij de presentatie van een nieuwe AI-voorspelmodule, ontwikkeld voor artsen om zelf zulke modellen te kunnen modellen, viel mijn mond open bij de volgende bewering: “ons model resulterende in een test prestatie van 0.695, terwijl het klassieke model een prestatie geeft van 0.689, dus ons model is beter”. Los van of bovenstaand verschil überhaupt wel relevant is, schreeuwt zo’n bewering natuurlijk om een goed statistisch vergelijk. En ja, daar zijn al veel standaardmethodieken voor, dus AI-ers: gebruik die dan ook!
Onzekerheidskwantificatie: Moet je daarvoor statisticus zijn?
Mijn antwoord hierop is een volmondig ‘ja’. AI-wetenschappers kunnen veel, heel veel. Ze zijn goed in wiskunde en geweldig sterk in software-implementatie. Veel beter dan wij statistici. Maar onzekerheid zit niet in hun systeem, niet in hun opleiding en vaak niet in hun methodieken. Een statisticus wordt getraind te denken in onzekerheden en het herkennen van verschillende bronnen daarvoor. We worden opgeleid met een dobbelsteen in de ene hand en Occam’s scheermes in de andere. De eerste om onzekerheid te kwantificeren, de tweede om deze in te perken, want eenvoudige modellen zijn vaak stabieler. Plus we koppelen onzekerheid aan het ontwerp van de studie (hoeveel individuen, hoeveel herhalingen, etc). U wilt niet weten hoe vaak wij ook in dit tijdperk nog gevraagd worden om steekproefgrootteberekeningen te doen. Voor dit ultieme ‘kijken in de glazen bol’ vertrouwt men de statisticus toch nog het meest, blijkbaar.
Een mooi vakgebied ontstaat: Statistical AI
Op het snijvlak van de statistiek en AI liggen dus geweldige uitdagingen. En gelukkig ontstaat er ook een gemeenschap die zich hiermee bezighoudt. Zo is ‘conformal prediction’, een techniek waarmee je de onzekerheid van een AI-voorspelling kunt kwantificeren, ook in de statistiekgemeenschap een belangrijk onderwerp aan het worden. En anderen ontwikkelen interval versies van importantiematen om daarmee het explainable AI veld te verrijken. Maar er is nog genoeg te doen, ook om het goed gebruik van deze technieken in de praktijk te bevorderen. Want AI voorspellingen zijn net zo goed waardeloos als ze ons niet de kennis verschaffen om betrouwbare beslissingen te kunnen nemen. Aan de slag dus maar!
Credits
Figuur: Udesh Habaraduwa

 Bernard Zweers

 Carolien de Kovel


 Elia Gonzato


 Miriam Loois

 Simone Griffioen

Add comment